
数据的分析
一、平均数
(一)平均数的意义
[知识点] 平均数
定义:平均数是一组数据的平均值,表示这组数据的集中趋势。
记作:
(二)算术平均数
[知识点] 算术平均数
定义:对于 个数据 ,它们的算术平均数为所有数据之和除以数据的个数。
计算公式:
或
其中:
表示所有数据之和;
表示数据的个数。
(三)加权平均数
[知识点] 加权平均数(一般形式)
定义:若 个数据 的权分别是 ,则这组数据的加权平均数为:
其中:
表示数据;
表示对应数据的权,权反映数据的重要程度。
[知识点] 加权平均数(频数形式)
定义:若数据 出现的次数(频数)分别为 ,则加权平均数为:
其中:
表示第 个数据;
表示 出现的个数(频数);
表示数据的总个数。
[!tip] 当各数据的权相同时,加权平均数就是算术平均数。
二、众数
[知识点] 众数
定义:一组数据中出现次数最多的数据称为这组数据的众数。
特点:众数反映一组数据的集中趋势;一组数据的众数可能不止一个,也可能没有。
三、中位数
[知识点] 中位数
定义:将一组数据按从小到大(或从大到小)的顺序排列后,居于中间位置的数称为这组数据的中位数。
求法:
当数据个数为奇数时,中位数就是中间位置的那个数;
当数据个数为偶数时,中位数是中间两个数之和除以 2。
特点:中位数不受极端值影响,具有比较好的代表性。
四、方差
[知识点] 方差
定义:方差是衡量一组数据波动大小的数。
记作:
计算公式:
其中:
是这组数据的平均数;
是数据的个数;
是各数据。
特点:
方差大,说明数据波动大;
方差小,说明数据波动小。
五、四分位数
[知识点] 四分位数
定义:把一组按大小顺序排列的数据分成四等份的三个分点上的数,叫做四分位数,分别是下四分位数 Q1、中位数 Q2、上四分位数 Q3。
各部分:
Q1(下四分位数):位于数据约 25% 位置的数;
Q2(中位数):位于数据 50% 位置的数,即中位数;
Q3(上四分位数):位于数据约 75% 位置的数。
[知识点] 箱线图
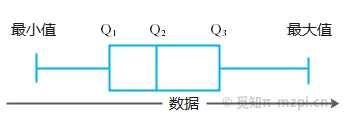
定义:箱线图(又称盒须图)是用一组数据的五个要素(最小值、Q1、中位数、Q3、最大值)以及四分位距来直观展示数据分布情况的统计图。
四分位距:四分位距 = Q3 – Q1,反映中间 50% 数据的离散程度。
特点:箱线图能直观地展示数据的分布、中心位置和离散程度。
六、数据的分组
[知识点] 数据的分组
定义:把一组数据按某一分界点分成"好"和"差"两组,关键在于选择合适的分界点。
分组原则:
组内差异小:同一组内的数据尽量接近;
组间差异大:不同组之间的数据差异尽量明显。
操作步骤:
排序:把数据按从小到大排列;
找间隔: 个数据有 个可能的分界点;
逐个计算:以每个分界点为界将数据切成左右两组,分别计算第一组、第二组的离差平方和、,再相加得到组内离差平方和(即组内数据的离散程度)。
比较选优:比较各分界点对应的组内离差平方和,值越小说明数据越集中,对应的分界点越优。